mundial-2026-ml
Un predictor del Mundial 2026: estima cómo termina cada partido y simula el torneo completo cinco mil veces para dar la probabilidad de que gane cada selección.
Arquitectura
Un pipeline de cuatro pasos —datos, variables, modelos y backtest— sobre 49.509 partidos guardados en SQLite, con las variables construidas hacia adelante en el tiempo y un tablero al final.
- El histórico sale de un dataset público de partidos internacionales desde 1872. Se modela desde 2000, que son 25.444 filas.
- Cada fila lleva Elo, forma reciente, historial directo y ranking, y el Elo se actualiza después de emitir la fila para que no lea su propio resultado.
- El corte de entrenamiento es una fecha y no un porcentaje: entrenamiento hasta 2021, calibración de 2022 a 2024, prueba de 2025 en adelante.
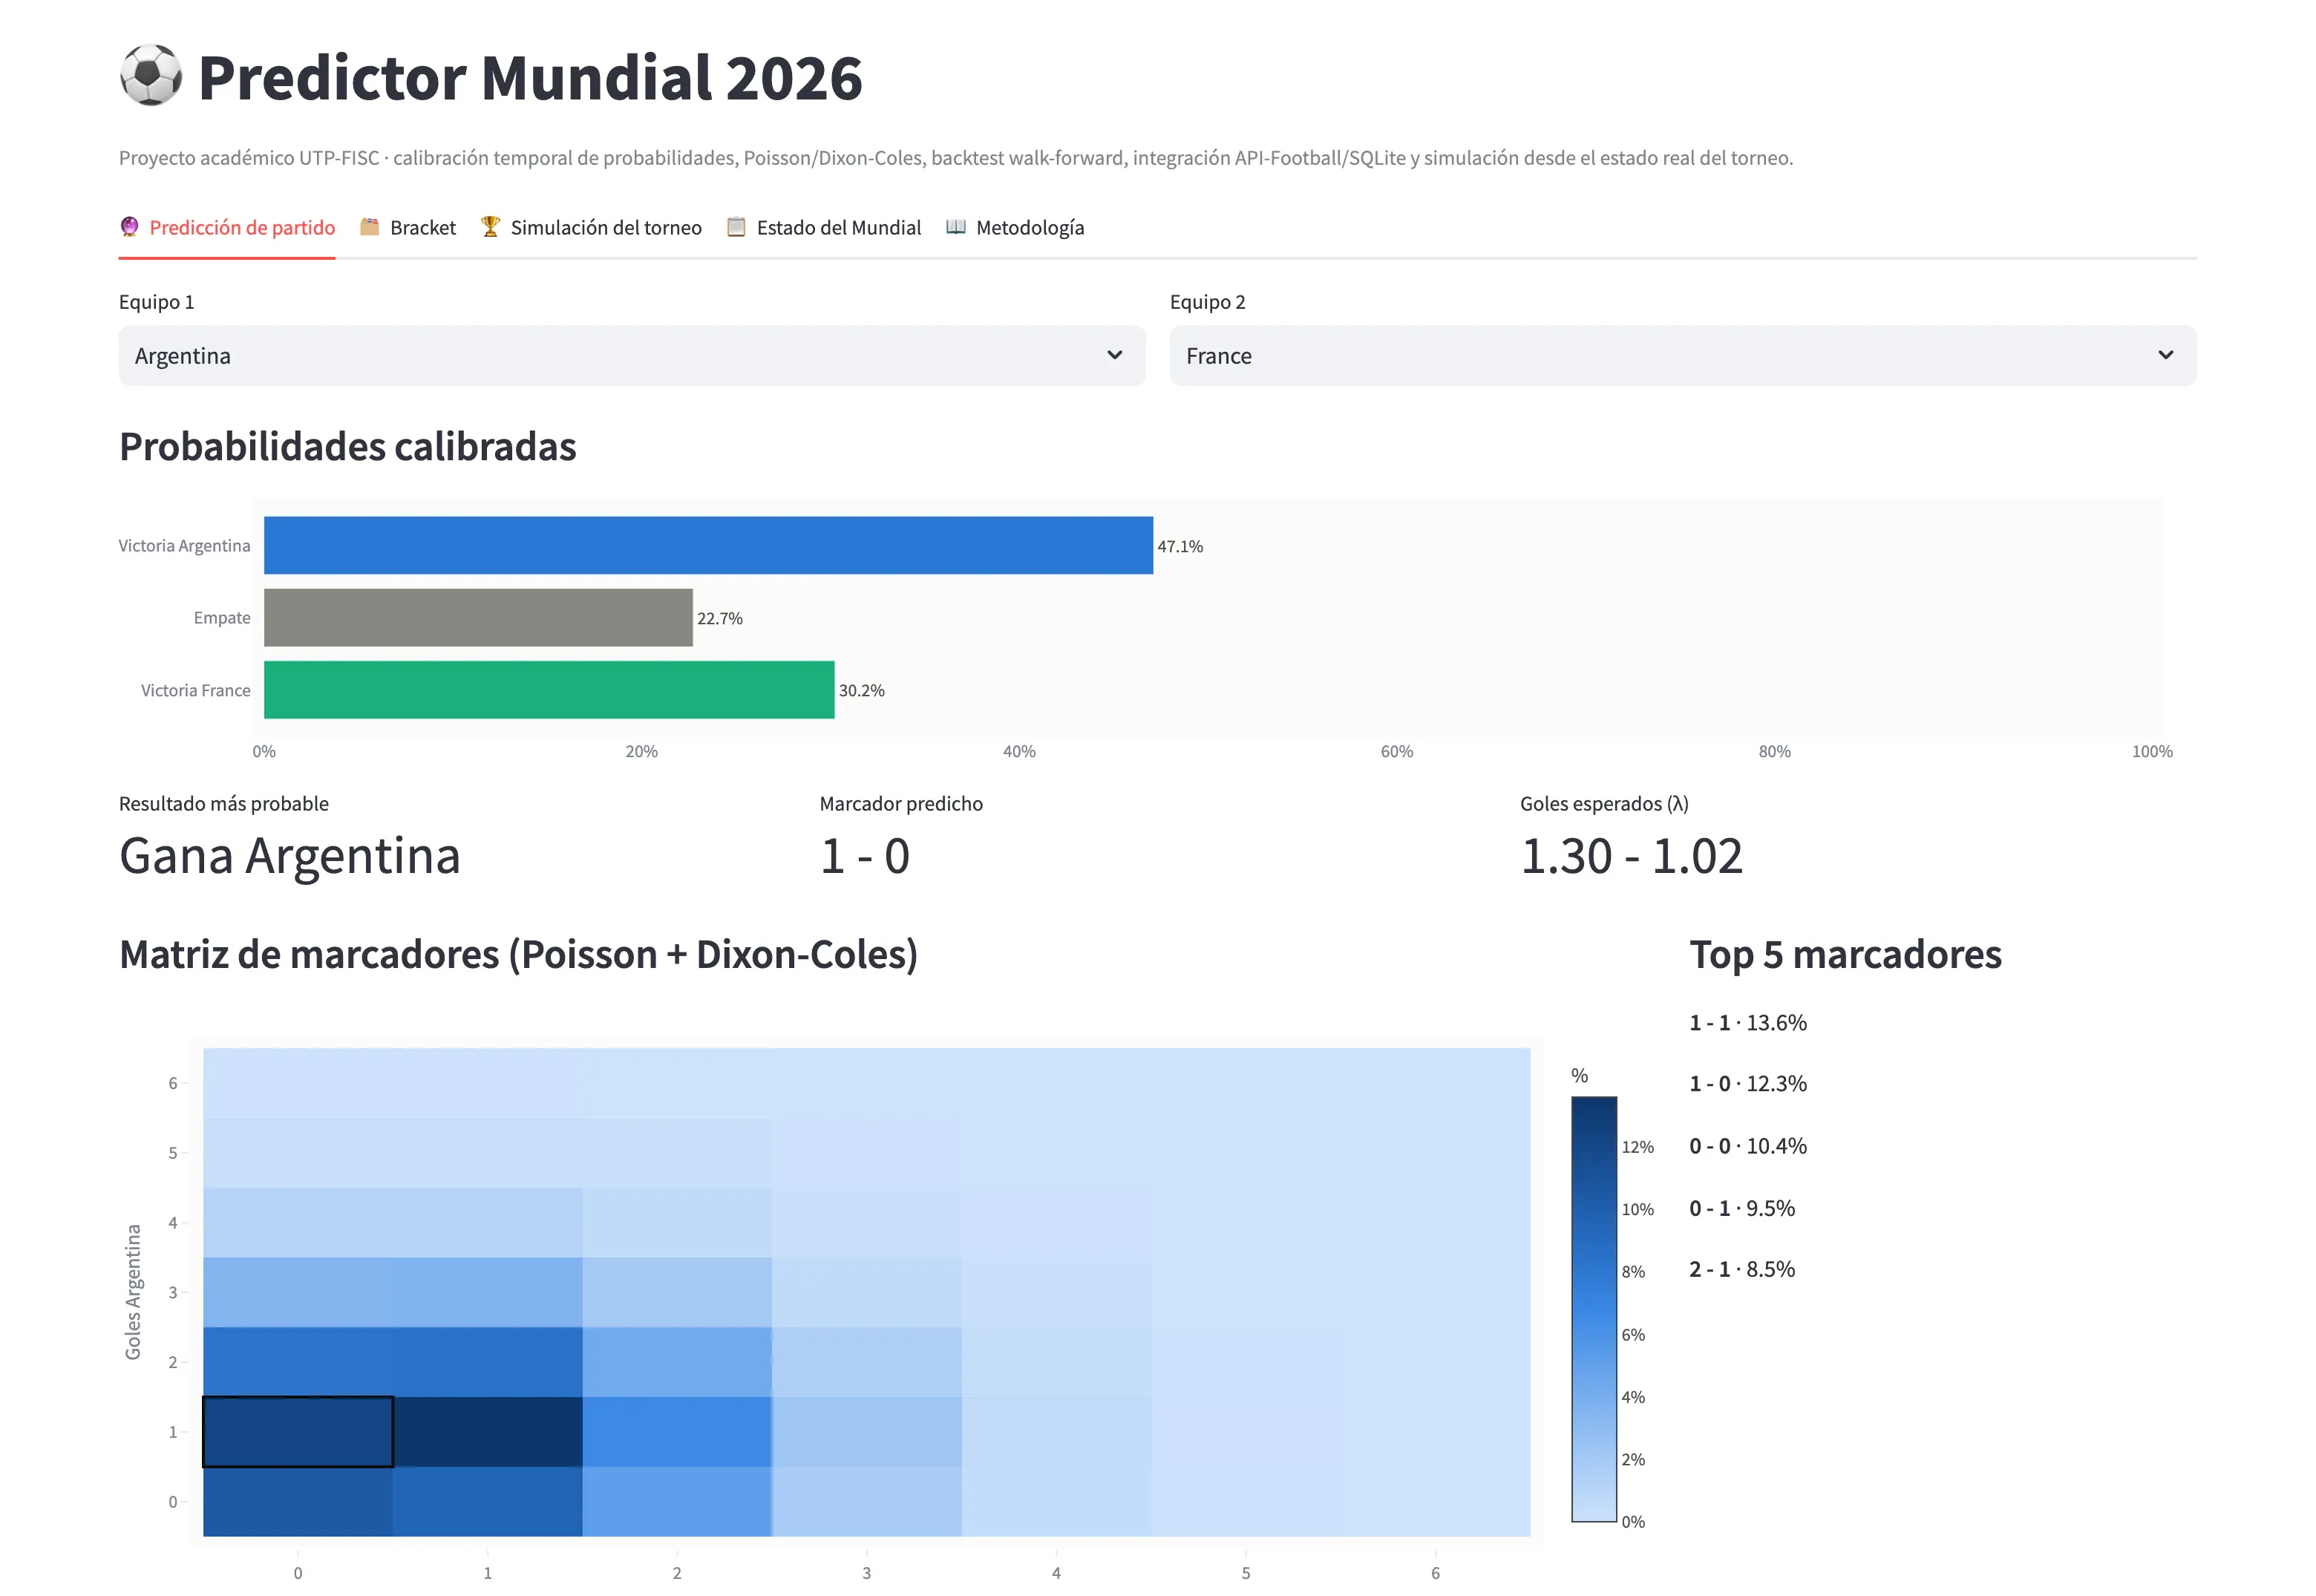
- El marcador sale de un Poisson con corrección Dixon-Coles, y el torneo completo se simula por Monte Carlo cinco mil veces.
Datos pandas · numpy · SQLiteModelado scikit-learn · GradientBoosting · PoissonRegressor · Dixon-ColesEvaluación backtest de ventana expansiva · RPS escrito a manoSimulación Monte Carlo, 5.000 torneosInterfaz Streamlit · plotly
Lo que me llevo
Buscar la fuga en mi propio código valió más que subir la accuracy. Encontré cinco variables contaminadas de catorce y las publiqué con lo que costaría arreglarlas, así que las métricas del repositorio son un techo optimista — y lo digo yo antes de que lo encuentre quien lea el código.
El caso completo — las decisiones, la evidencia y lo que falta
Esto empezó como una entrega para la materia de Programación en la UTP y creció por una razón concreta: casi todo lo que se publica sobre predicción de fútbol reporta su accuracy sobre una partición aleatoria, y una partición aleatoria en datos con orden temporal deja que el modelo aprenda del futuro. Quise saber cuánto de esa accuracy sobrevive a un corte honesto por fecha.
La respuesta, sobre 7.797 partidos entre 2018 y 2025 que el modelo nunca vio en su entrenamiento: 59,96 %. Y una segunda respuesta que no buscaba: cinco de mis catorce variables sí tienen fuga, de dos tipos distintos, y las encontré auditando mi propio código después de haber escrito el README que afirmaba lo contrario. El segundo tipo lo encontré incluso después de publicar las métricas. Están documentadas más abajo, con lo que costaría arreglarlas.
El Elo se actualiza después de emitir la fila, no antes
Lo que costóUn bucle secuencial en vez de una operación vectorizada
- Situación
La fuerza de un equipo es la variable más predictiva que hay, y hay que calcularla para cada partido usando sólo lo que se sabía antes de ese partido.
- La decisión
El Elo se precalienta con todo lo anterior a 2000, y desde ahí el bucle escribe primero la fila de features y actualiza el estado después. Con
k = 32en competitivo yk = 16en amistoso.- Lo que descarté
Calcular el Elo sobre toda la tabla y unirlo de vuelta por equipo, que es lo que hace la mayoría de las implementaciones publicadas y es mucho más corto de escribir. Filtra el futuro a cada fila: el Elo de un equipo calculado sobre la tabla completa ya sabe cómo le fue en los partidos siguientes. La forma reciente y el historial entre los dos equipos se acumulan con la misma regla, estrictamente desde filas anteriores.
- La consecuencia
Nueve de las catorce variables sólo leen el pasado, y la construcción es un bucle secuencial en vez de una operación vectorizada — más largo de escribir y, espero, más lento, aunque no lo he cronometrado —, a cambio de que el número final signifique algo. Las otras cinco son la excepción, y están declaradas más abajo.
El corte de entrenamiento es una fecha, no un porcentaje
Lo que costóMenos datos de entrenamiento y una métrica publicada más baja
- Situación
Hacía falta partir los datos en entrenamiento, calibración y prueba de una forma que no se pudiera confundir con hacer trampa.
- La decisión
Entrenamiento hasta 2021, calibración de 2022 a 2024, prueba desde 2025. Y un muro duro: nada con fecha posterior al 10 de junio de 2026 entra al entrenamiento, que es el día antes del inicio del torneo que el modelo predice.
- Lo que descarté
Un
train_test_splitcon mezcla aleatoria, que es la línea por defecto de scikit-learn y lo que se ve en la mayoría de los cuadernos del tema. Sobre datos con orden temporal, entrena con partidos de 2024 para predecir partidos de 2019. La accuracy que sale de ahí no es comparable con la de arriba y suele ser bastante más alta.- La consecuencia
Ningún partido con fecha posterior al corte entra al modelo que lo predice, ni siquiera cuando el pipeline se vuelve a correr a mitad del torneo — y se volvió a correr. Con un agujero que descubrí después y que explico abajo: el muro filtra por la fecha de cada fila, y hay dos variables que no se calculan fila a fila. El costo es que hay menos datos de entrenamiento que con una partición aleatoria, y que la métrica publicada es más baja de lo que sería con la partición fácil.
Un backtest de ventana expansiva, con RPS escrito a mano
Lo que costóOcho reentrenamientos por cada cambio de variable
- Situación
Un solo número sobre un solo conjunto de prueba no dice si el modelo es estable o si tuvo suerte con el año que le tocó.
- La decisión
Para cada año de 2018 a 2025, reentrenar usando sólo datos anteriores y evaluar sobre ese año. Y medir con RPS además de log-loss, con la implementación escrita a mano.
- Lo que descarté
Reportar sólo accuracy, que trata los tres resultados como categorías sin relación. Ganar, empatar y perder están ordenados: predecir victoria visitante cuando el resultado fue empate debería costar menos que predecirla cuando el resultado fue victoria local. El RPS respeta ese orden y ni scikit-learn ni los conjuntos de métricas habituales lo traen, así que hay que escribirlo.
- La consecuencia
Hay un número por año y se ve la dispersión: los dos mejores años, 2021 y 2025, rondan el 64 %, y el peor, 2018, baja a 52,4 %. El promedio ponderado sobre los 7.797 partidos es el 59,96 % de arriba. El costo es ocho reentrenamientos en vez de uno cada vez que cambia una variable.
El resultado negativo del día uno
Lo que costóSin estadísticas avanzadas: el modelo es más simple de lo planeado
- Situación
El plan original era alimentar el modelo con estadísticas avanzadas de una API de fútbol comercial, en su plan gratuito.
- Lo que rompía
Escribí un script de validación antes que cualquier otra cosa y descubrí el primer día que el plan gratuito no cubre la temporada 2026 — sólo llega hasta 2024. Todo el diseño que dependía de esas estadísticas estaba muerto antes de empezar.
- La decisión
Una cascada explícita de fuentes: la API primero, un conjunto de datos público de partidos internacionales después, y un CSV manual al final. El sistema funciona con la fuente que tenga disponible.
- Lo que descarté
Empezar a construir sobre la API y validar la cobertura cuando hiciera falta, que es lo natural y lo que habría descubierto el problema en la tercera semana, con el pipeline ya escrito alrededor de datos que no existen.
- La consecuencia
No hay estadísticas avanzadas por equipo, así que el Elo y el ranking cargan toda la señal — eso es una restricción documentada y no una sorpresa. El costo real fue de alcance: el modelo es más simple de lo que planeé, y lo es por una razón que puedo nombrar.
Cómo se comprueba
Los números de arriba no hay que creérselos: están en dos CSV del repositorio. outputs/backtest_results.csv tiene una fila por año y la fila weighted_mean con el promedio ponderado sobre los 7.797 partidos. outputs/calibration_report.csv tiene la tabla que se discute abajo. Los dos los regenera python -m scripts.build_all, que trae un --skip-backtest porque el backtest es el paso más lento; cuánto tarda la pasada completa no lo he cronometrado y no lo voy a estimar aquí.
Y hay que mirar las fechas de esos archivos antes de que las mire otro. Los dos CSV no son de la misma pasada. data/processed/match_features.csv, los dos .pkl de models/ y calibration_report.csv llevan fecha del 15 de julio; backtest_results.csv y build_metadata.json se quedaron en el 5 de julio, porque la última pasada saltó el backtest. El código de features y de modelado no cambió entre esas dos fechas —los archivos de src/ son todos del 5 de julio—, pero los datos sí: las métricas publicadas arriba son de ese código sobre el histórico de diez días antes, no de los modelos que hoy están en models/. Volver a alinearlas es correr el backtest sin --skip-backtest. No lo he hecho.
Que el Elo se actualiza después de emitir la fila se comprueba leyendo el bucle de construcción de features: la fila se agrega a la lista antes de que se toque elo_state. Y las fugas también se comprueban leyendo, que es exactamente como las encontré.
Las cinco fugas que encontré en mi propio código
El README de este repositorio decía que las features se construyen «sin fuga de datos». Es cierto para nueve de las catorce y falso para cinco, que se reparten en dos tipos distintos. Lo descubrí auditando el archivo después de haberlo escrito, y el segundo tipo lo encontré en una segunda pasada, cuando las métricas de arriba ya estaban publicadas.
Tipo uno: el snapshot del ranking FIFA, en tres variables. fifa_diff es la diferencia de puntos del ranking FIFA entre los dos equipos. El código carga un solo archivo de ranking, con fecha 2026-06-11, y lo consulta para cada fila del histórico:
home_fifa = fifa_latest.get(home, home_elo)
away_fifa = fifa_latest.get(away, away_elo)
Para un partido de 2004 eso significa que la variable arrastra información de veintidós años después. Es fuga de la difícil de ver: no viene del resultado de la propia fila —el elo_diff que va al lado sí está bien construido, se escribe después de emitir la fila— viene de una tabla que parecía estática y no lo es.
Y no es una variable, son tres. El mismo records.append escribe también fifa_diff_x_home_form y fifa_diff_x_away_form, que son literalmente fifa_diff multiplicado por la forma reciente de cada equipo: el snapshot entra intacto en las dos. Durante un tiempo declaré sólo fifa_diff y presenté las otras trece como limpias. Eso era la versión optimista del mismo error, y contarlo así es peor que no haber auditado, porque suena a que audité.
Tipo dos: la tasa de penales, en dos variables, y esta no la había declarado en ninguna parte. home_penalty_win_rate y away_penalty_win_rate no se calculan fila a fila. Se calculan una sola vez, sobre data/raw/shootouts.csv entero, antes de que empiece el bucle walk-forward:
wins = shootouts["winner"].value_counts()
games = pd.concat([shootouts["home_team"], shootouts["away_team"]]).value_counts()
penalty_win_rate = (wins / games).fillna(0.5).to_dict()
Un partido de 2001 recibe una tasa calculada con tandas de hasta el 7 de julio de 2026. De las 682 tandas del archivo, 168 —el 24,6 %— son de 2018 en adelante, es decir, en la ventana de prueba o más allá de ella: 150 caen dentro de 2018–2025 y 18 son de 2026, pasado su final. Esto no es un snapshot reutilizado como el anterior: es el resultado agregado de partidos que el modelo no debería haber visto, los mismos que tenía que predecir en la ventana de prueba. Es otra clase de fuga, y la clase importa, porque el arreglo también es otro.
Y por aquí es por donde el muro duro tiene el agujero que anuncié en la decisión 2. El corte filtra por la fecha de cada fila, así que ninguna fila posterior al 10 de junio de 2026 entra al entrenamiento ni a la evaluación; pero la tasa de penales se agrega antes de ese filtro y sobre el archivo completo, que incluye las cuatro tandas del propio Mundial 2026 posteriores al corte: Alemania-Paraguay y Países Bajos-Marruecos el 29 de junio, Australia-Egipto el 3 de julio y Suiza-Colombia el 7 de julio. Presenté ese corte como la garantía de que el torneo en curso no puede filtrarse al modelo que lo predice. Por esta ruta sí puede, y parcialmente lo hace.
Dos cosas que no voy a afirmar. No voy a afirmar que el efecto sea pequeño, porque no lo he medido para ninguna de las cinco. Y no voy a afirmar que el 59,96 % de arriba esté libre de ellas, porque no lo está: backtest.py relee el mismo match_features.csv, así que ese número, y el 0,879, el 0,517 y el 0,172 que van a su lado, están todos medidos con las cinco fugas dentro. Son un techo optimista, no una estimación limpia. Son los números que tengo, no los que me gustaría tener.
Lo que sí puedo decir es qué costaría arreglarlo y cómo se sabría el tamaño del daño. Para las tres del ranking hace falta la serie histórica del ranking FIFA por fecha de publicación, unirla a cada partido por su fecha con un merge_asof, y las dos interacciones se arreglan solas al arreglar el factor. Para las dos de penales hace falta mover la agregación dentro del bucle, acumulando cada tanda sólo después de emitir su fila, igual que el Elo. Y después volver a correr el backtest de ventana expansiva. Si la accuracy ponderada baja poco, esas cinco eran casi redundantes con elo_diff y el modelo nunca dependió de ellas. Si baja mucho, el número publicado era optimista y toca republicarlo. Las dos respuestas son útiles. Ninguna la tengo todavía.
La calibración no mejoró las métricas, y la dejé puesta
outputs/calibration_report.csv tiene tres filas y dice algo incómodo:
| probabilidades | accuracy | log-loss | Brier |
|---|---|---|---|
| raw | 0,6291 | 0,8287 | 0,4878 |
| isotonic | 0,6230 | 0,8848 | 0,4916 |
| sigmoid | 0,6283 | 0,8374 | 0,4904 |
El modelo sin calibrar gana en las tres. La selección se queda con sigmoid porque está escrita así:
best_method = min(("isotonic", "sigmoid"), key=lambda m: metrics[m]["brier"])raw se mide, se imprime y se guarda en el reporte, pero no entra al min. Eso no es una decisión, es un descuido en el código de selección, y prefiero llamarlo por su nombre antes de defenderlo.
¿Debería entonces quitar la calibración? No estoy seguro, y ahí está la parte interesante. Quien consume estas probabilidades no es una métrica: es un simulador Monte Carlo que las muestrea 5.000 veces por torneo. Ahí no basta con que la probabilidad esté bien ordenada; importa que su nivel sea correcto, porque un modelo que dice 70 % donde la frecuencia real es 60 % produce demasiados campeones favoritos y las probabilidades de campeón salen sesgadas. El Brier mide las dos propiedades juntas en un solo número y por eso no responde esta pregunta.
La forma de responderla es descomponer el Brier en confiabilidad y resolución, o comparar directamente las probabilidades de campeón que produce el simulador con raw frente a con sigmoid. No lo he hecho. Hasta que lo haga, lo honesto es esto: la calibración está puesta por un argumento que suena bien y que no he verificado, y las métricas publicadas arriba son las del backtest, no las de este cuadro.
Cero pruebas y cero integración continua
No hay un solo test_, no hay pytest.ini, no hay workflow. En un proyecto cuyo argumento central es «mi metodología de evaluación es honesta», la ausencia de pruebas es la crítica más justa que se le puede hacer: la construcción walk-forward de las features es exactamente el tipo de código que una prueba debería fijar, porque un cambio inocente en el orden de dos líneas reintroduce una fuga sin que nada se queje. Las cinco fugas de arriba son la prueba: en este repositorio no había nada que las fuera a atrapar salvo yo leyendo el archivo.
El sorteo y los penales
En el modo que simula el torneo completo, el sorteo del cuadro es aleatorio en vez de seguir las reglas reales de emparejamiento por grupo y confederación. Y las tandas de penales se resuelven con la tasa histórica de cada equipo, no con un modelo — la misma tasa agregada de una vez que arriba declaro como fuga. Las dos cosas ensanchan la incertidumbre de las probabilidades de campeón más allá de lo que sugiere el número de simulaciones.