loklflow
Un sistema para llevar un restaurante entero: toma de comandas, pantalla de cocina, plano de mesas, inventario, cierre de caja y permisos por rol.
Arquitectura
El servidor —NestJS y PostgreSQL— corre dentro del establecimiento, sobre un UPS, y caja, meseros y cocina hablan con él por la WiFi interna. La nube sólo recibe el tablero remoto y el respaldo.
- Un monorepo con dos aplicaciones: la API en NestJS y la interfaz en Next.js.
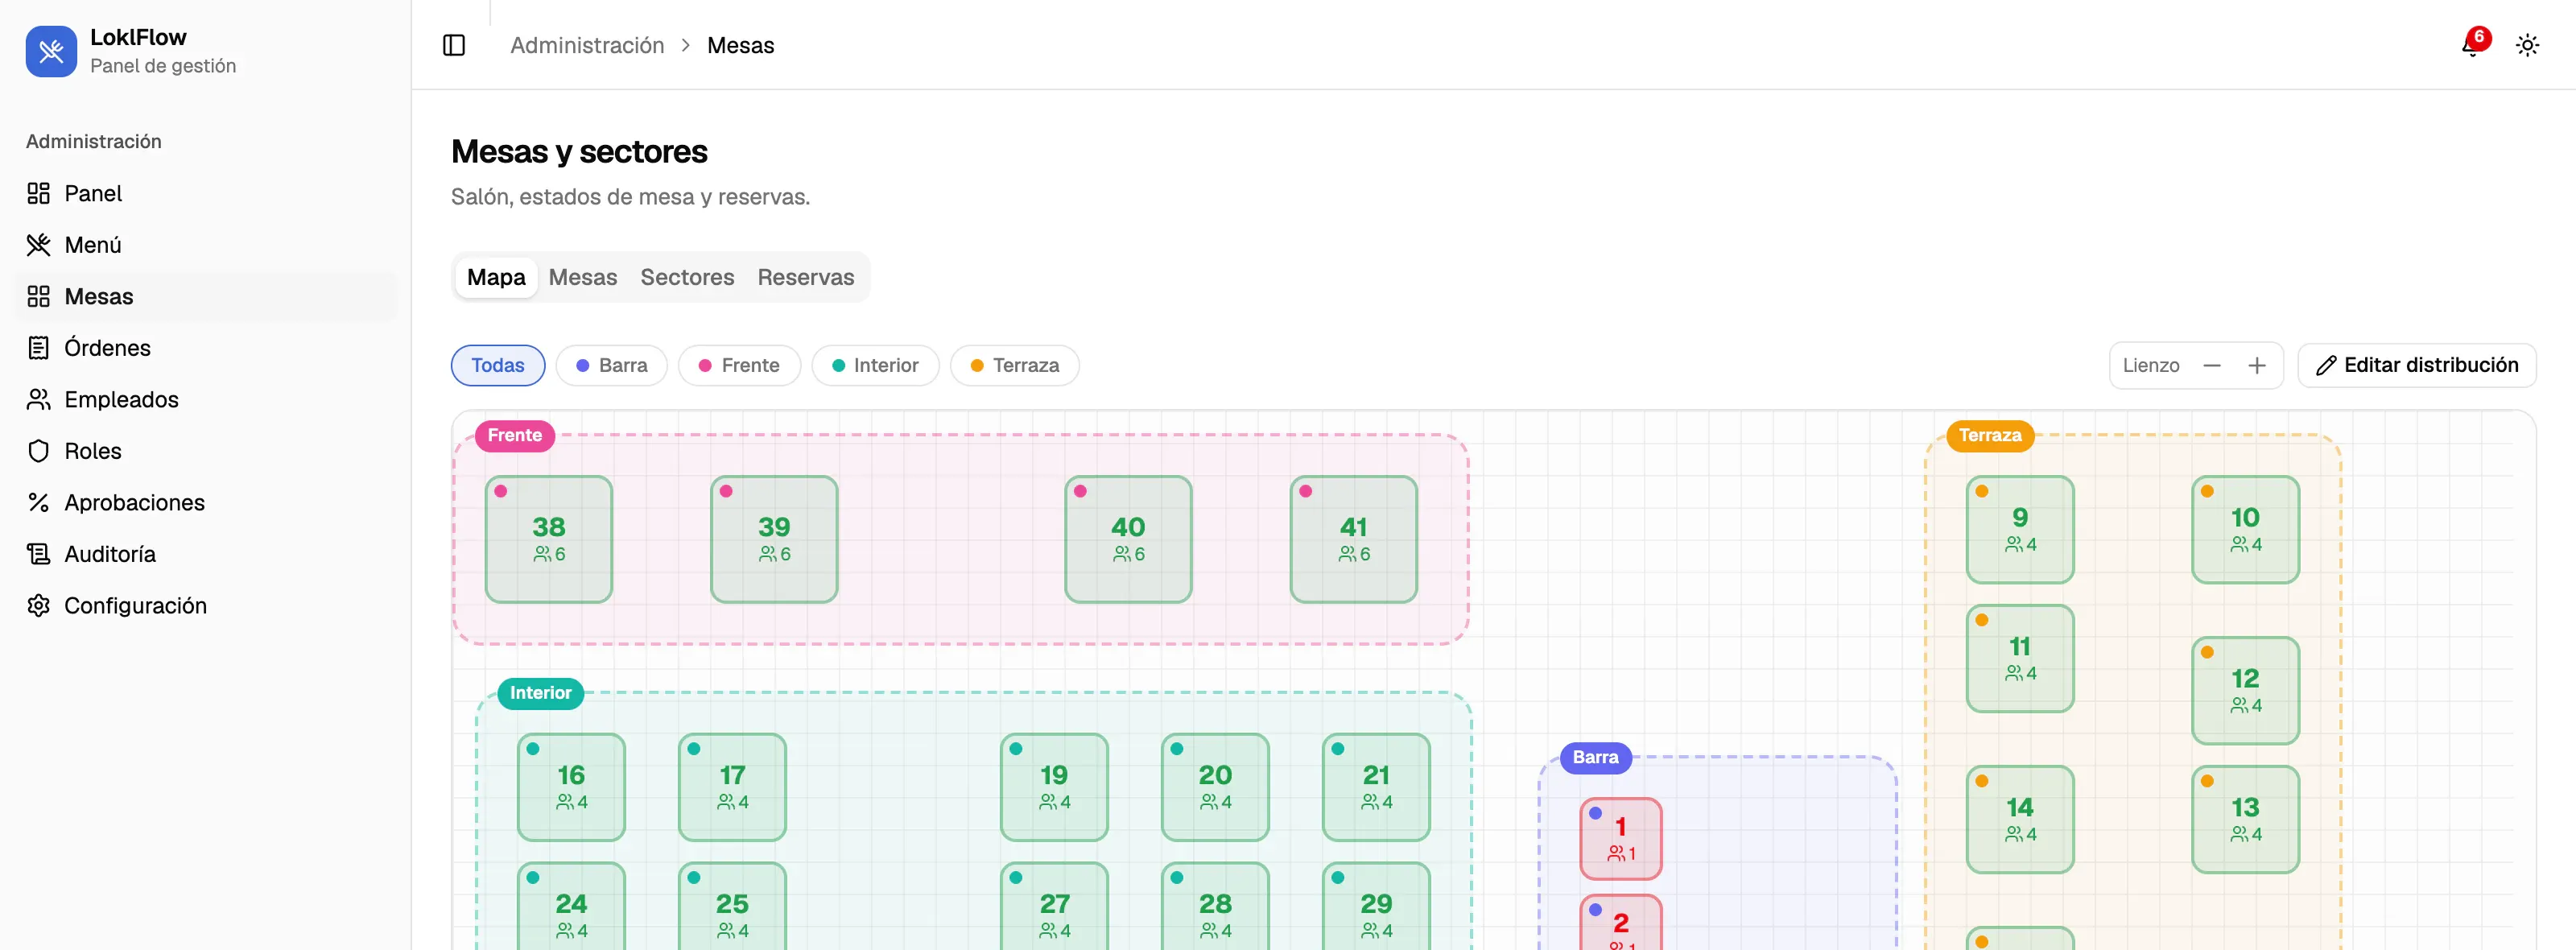
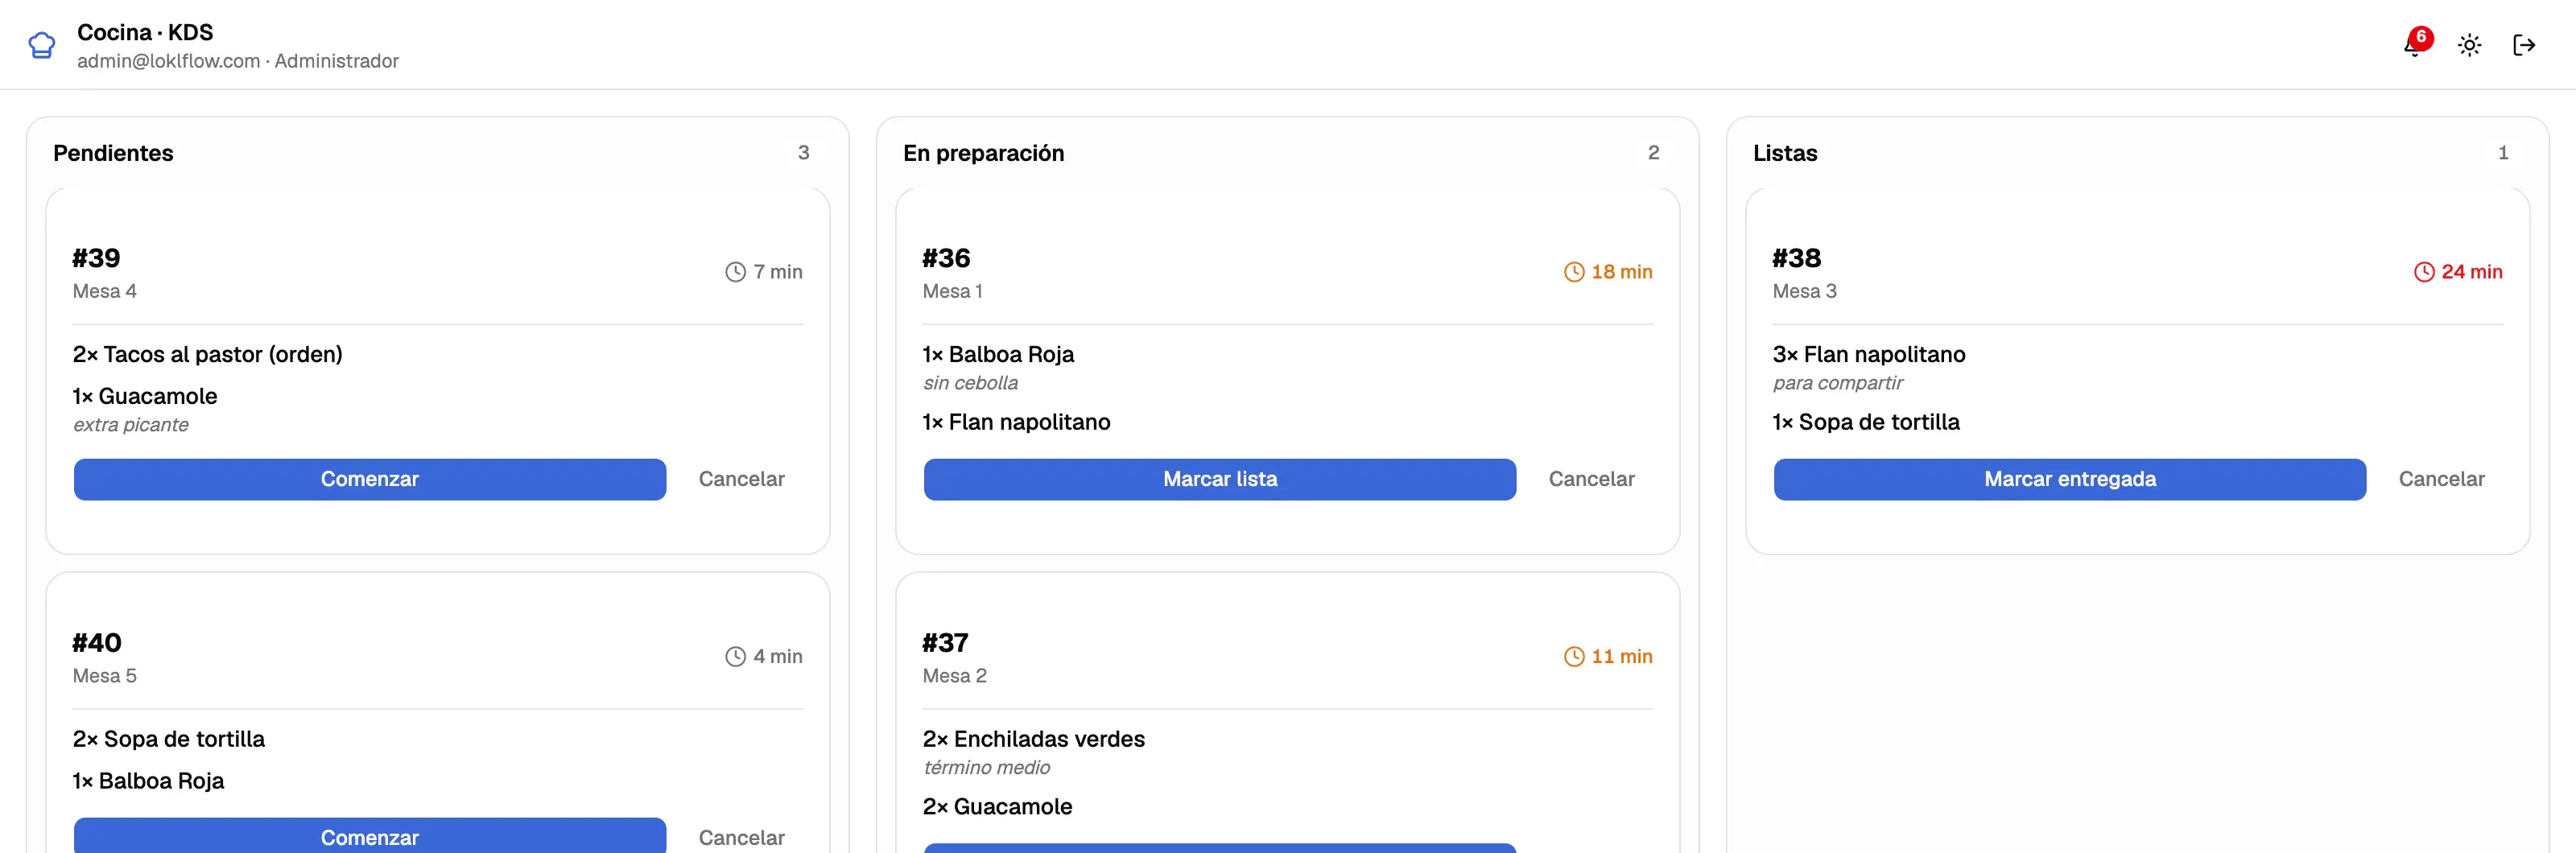
- Las comandas y el estado de las mesas viajan en vivo por WebSocket, sin recargar pantalla.
- El uuid que genera el dispositivo es la clave primaria de la orden y de sus líneas, así que reenviar una operación devuelve el estado en vez de duplicar la cuenta.
- Con la API caída, las tres pantallas operativas siguen trabajando contra una cola en el propio dispositivo. Cobrar y abrir turno siguen exigiendo red, a propósito.
Backend NestJS 11 · TypeORM · Socket.ioDatos PostgreSQL 16 · migraciones versionadasFrontend Next.js 16 · React 19 · Tailwind 4 · ZustandPruebas Jest · Vitest · supertestInfraestructura Docker · GitHub Actions
Lo que me llevo
De un sistema que tiene que aguantar sin red, la mitad que no se puede añadir después es la del servidor. Que reenviar una operación devuelva el estado en vez de duplicar el cobro tuvo que estar antes de que existiera la cola en el dispositivo: al revés no se llega, porque para entonces ya hay cobros dobles en la base.
El caso completo — las decisiones, la evidencia y lo que falta
En un restaurante de Ciudad de Panamá el internet se cae. No siempre y no por mucho tiempo, pero se cae a las 8:40 de un viernes con catorce mesas ocupadas. Un punto de venta alojado en la nube deja de cobrar en ese momento; uno alojado en el propio local, no.
Por eso el servidor de este sistema corre dentro del establecimiento, sobre un UPS, y los clientes —caja, meseros, cocina— hablan con él por la WiFi interna. La nube queda para las dos cosas que de verdad la necesitan: el tablero remoto del dueño y el respaldo. Esa decisión de topología explica casi todas las demás, incluida una que hoy se ve desde fuera: la instancia que tengo desplegada está en la nube, que es justo donde este sistema dice que no debe estar.
Conviene que diga qué es esa instancia antes de que alguien la abra. loklflow.juank.tech corre sobre un Dokploy autoalojado detrás de Traefik: está desplegada y en marcha, cerrada por sesión, y no publico credenciales de demo — quien sepa la URL llega al login y ahí se queda. Es una excepción de demostración y no la topología que defiende este caso: está remota, y lo que este sistema defiende es poner el servidor en el mismo local que las tabletas. Ésa no se puede enseñar por una URL.
El servidor va en el local, no en la nube
Lo que costóLa instancia de demostración corre en la nube: es el modo de fallo que describe el caso
- Situación
Tomar una orden y cobrarla son las dos operaciones que no pueden depender de que el proveedor de internet esté teniendo un buen día.
- La decisión
El servidor —NestJS y PostgreSQL— corre en el local, sobre un UPS, y los dispositivos se conectan por la red interna. La nube sólo recibe el tablero remoto y el respaldo.
- Lo que descarté
Una API en la nube con la red del local como cliente delgado, que es la arquitectura por defecto y la que yo habría elegido por inercia. Pierde en el único momento que importa: cuando se cae el enlace, un cliente delgado no tiene nada que hacer. También descarté una app nativa por dispositivo, que resolvería lo mismo a cambio de tres bases de código y una tienda de aplicaciones.
- La consecuencia
El internet deja de ser una dependencia para operar. El costo es grande y hay que decirlo: el despliegue de verdad implica meter una máquina en una cocina, sobre un UPS, y mantenerla ahí. Lo que corre en
loklflow.juank.techno es eso: es una excepción de demostración, remota, y por tanto el único despliegue de este sistema que depende del enlace para todo y no sólo para cobrar. Está cerrado por sesión y no publico credenciales de demo.
El número de orden sale de una secuencia de Postgres
Lo que costóLos números pueden saltar si una transacción aborta
- Situación
Cada orden lleva un número corto y legible que el mesero canta en la cocina. Tiene que ser único y no puede saltar de forma rara.
- Lo que rompía
Estaba calculado como
MAX(order_number) + 1. Ocho creaciones simultáneas devolvieron 500: varias leyeron el mismo máximo, la primera ganó, y los reintentos de las demás volvieron a chocar entre sí. El propio comentario de la migración lo dice: con dos meseros tomando nota a la vez, la orden se perdía.- La decisión
Una secuencia de Postgres consultada con
nextval. La numeración es atómica y no hay código de reintento.- Lo que descarté
Un
SELECT … FOR UPDATEsobre la última orden, que serializa correctamente y pondría cada creación de orden a esperar detrás de la anterior — justo en la hora pico, que es cuando el problema aparece. No lo medí: lo descarté por lo que espero que haga, no por un número. Y también un reintento con espera aleatoria sobre elMAX, que reduce la probabilidad sin eliminarla.- La consecuencia
Ocho creaciones simultáneas producen ocho números distintos, y hay una prueba de integración que lo afirma. La secuencia se declaró a propósito sin
SET DEFAULTy sinOWNED BY, para que la sincronización automática de TypeORM en desarrollo no pelee con ella. El costo es que los números pueden saltar si una transacción aborta:nextvalno se devuelve. Para un consecutivo operativo eso es aceptable; para un folio fiscal no lo sería.
El uuid del dispositivo es la clave primaria de la orden
Lo que costóUna lectura extra antes de cada escritura; el cliente decide el id
- Situación
Si un dispositivo va a poder reenviar una orden que quizá ya llegó, hace falta que el servidor pueda reconocerla como la misma orden y no como una nueva.
- La decisión
El dispositivo genera el uuid y ese uuid es la clave primaria de la orden y de sus renglones. Antes de escribir, el servicio busca si ya existe y, si existe, devuelve la que hay.
- Lo que descarté
Un id generado por el servidor más una columna
client_request_id, que funciona pero obliga a traducir identificadores en el momento de sincronizar. Y —esto es lo importante— descarté capturar la violación de clave única y tratarla como «ya existía». Con TypeORM eso no funciona:save()sobre una entidad con clave primaria existente no falla, hace unUPDATE. Habría sobrescrito la orden en silencio y, por la cascada, también sus renglones. La excepción que esperaba nunca llega.- La consecuencia
Cinco reenvíos concurrentes del mismo uuid dejan exactamente una fila, y una prueba lo cuenta con
count(*). El costo es una lectura extra antes de cada escritura, y aceptar que el cliente decide el identificador — lo cual es correcto aquí y sería inaceptable si el id tuviera que ser secreto o impredecible.
El pago acepta una clave de idempotencia, única pero admitiendo nulos
Lo que costóGarantía opcional por cliente, no universal
- Situación
Un pago parcial se registra varias veces en una misma cuenta: alguien paga 40 de 100, luego 60. Un reenvío no puede convertirse en un cobro extra.
- Lo que rompía
El comentario de la migración que lo arregló lo dice sin adornos:
Hoy un pago completo repetido se rechaza de rebote —la cuenta ya está cerrada—, pero un pago parcial repetido pasa entero y suma: dos clics dejan 60 cobrados sobre una cuenta de 100. Con una cola de reintentos, sistemático.
apps/api/src/database/migrations/1785449564000-OrderNumberSequenceAndIdempotency.ts:14-16 La última frase es la que importa para la sección de más abajo: con una cola de reintentos automáticos, ese doble cobro deja de ser un accidente y pasa a ser el comportamiento normal.
- La decisión
payments.client_request_id, con índice único. El cliente que quiera garantía la manda; el que no, no.- Lo que descarté
Hacer la columna obligatoria, que es lo limpio y rompe al punto de venta conectado por cable, que no manda clave porque no la necesita. Y una segunda tabla de claves de idempotencia, que es la solución de manual y añade una escritura y una tabla para un caso que el índice resuelve.
- La consecuencia
El índice es único pero admite nulos, porque Postgres permite múltiples nulos en un índice único. Eso da una garantía opcional por cliente sin una segunda tabla. Y hay una prueba que afirma que el caso sin clave sí produce dos cobros distintos, porque ése es el comportamiento correcto y no una fuga: dos pagos parciales de verdad son dos pagos.
Un solo turno de caja abierto por cajero, garantizado por el índice
Lo que costóLa regla vive en dos lugares y manda la de abajo
- Situación
Un cajero abre turno, cobra durante su jornada y cierra con un arqueo. Todo el arqueo depende de que haya exactamente un turno abierto.
- Lo que rompía
La comprobación vivía en el servicio: leer si hay turno abierto, y si no, crearlo. Dos pestañas o un doble clic abren dos turnos. Los pagos se reparten entre los dos y ninguno cuadra.
- La decisión
Un índice único parcial: único sobre el usuario, pero sólo
WHERE status = 'open'. La violación del índice se traduce al mismo 400 que devolvería la comprobación normal.- Lo que descarté
Dejarlo en el servicio con una transacción y un bloqueo sobre la fila del usuario, que funciona y pone la garantía en el código que la lee en vez de en la estructura que la sostiene. Un índice único total tampoco servía: impediría el segundo turno del día siguiente.
- La consecuencia
La carrera dejó de existir, y como la violación se traduce, nunca sale a la superficie como un 500 — el cajero ve el mismo mensaje claro que veía antes. La comprobación del servicio se queda para el caso normal; el índice es la red debajo. El costo es que la regla vive ahora en dos lugares y hay que recordar que el de abajo es el que manda.
Sesiones para un salón, no para una oficina
El control de acceso es de denegación por defecto: JwtAuthGuard y PermissionsGuard están registrados como guardas globales, así que cada endpoint necesita un @RequirePermissions('módulo:acción') explícito o un @Public(). Son 30 permisos sobre 5 roles, con topes de descuento por rol de 100, 50, 10, 0 y 0 %.
Hay dos formas de entrar, porque un salón no es una oficina: correo y contraseña para administración, y un PIN de cuatro dígitos para el personal de piso, que no va a teclear una contraseña larga en una tablet cada vez. Las vidas son distintas a propósito — 15 minutos de acceso y 7 días de refresco para el correo, 4 horas y 12 horas para el PIN. Y el refresco propaga el método de login original: fijarlo a 'email' degradaba una sesión de PIN a 15 minutos y falseaba el registro de auditoría, que era el problema más grave de los dos. Cada refresco emite un identificador único, porque dos logins en el mismo segundo producían un token idéntico byte a byte contra una columna única.
Las dos mitades del modo sin conexión
Un sistema que aguanta perder la red tiene dos mitades. La primera es que el servidor sepa recibir la misma operación dos veces sin cobrarla dos veces. La segunda es que el cliente sepa guardar la operación mientras no hay servidor y reenviarla cuando vuelva. Están construidas en ese orden a propósito, y el orden es la decisión.
La primera mitad es la que no se puede añadir después. La clave primaria de una orden es el uuid que genera el dispositivo, así que un reenvío no tiene que traducir identificadores: es la misma fila. Los pagos aceptan clave de idempotencia con índice único. El número de orden sale de una secuencia. Ocho creaciones simultáneas producen ocho números distintos; cinco reenvíos del mismo uuid producen una sola fila. Las dos cosas están afirmadas por pruebas de integración que corren contra un PostgreSQL real con las migraciones aplicadas desde cero.
La segunda mitad se construyó encima. Hay una cola de operaciones en IndexedDB, ordenada por cuenta, con reintentos de espera creciente y un cerrojo entre pestañas para que dos no reenvíen lo mismo. Las tres superficies operativas —salón, comanda y cocina— leen del propio dispositivo y siguen trabajando con la API caída. Lo que no entra en la cola es el dinero: cobrar y abrir turno siguen exigiendo red, a propósito. Un cobro encolado se reenvía sin que nadie mire el resultado, y en un turno de caja eso es un arqueo que no cuadra; prefiero que el cajero vea «no hay red» a que crea que cobró.
Una cola de reenvíos montada sobre un servidor que no es idempotente no arregla nada: convierte un doble clic accidental en un doble cobro sistemático. Ese es exactamente el bug que documenta la migración de idempotencia, y el comentario de esa migración lo cierra en seis palabras — «con una cola de reintentos, sistemático». Construir la cola primero habría producido una demo que funciona sin WiFi y cobra de más.
El contrato del servidor se fijó primero y la cola del cliente se apoyó en él. Al revés no se llega: para cuando quieres el contrato, los cobros dobles ya están en la base.
Cómo se comprueba
Las afirmaciones de concurrencia son las que valen la pena correr, porque son las únicas que no se pueden verificar leyendo. pnpm --filter=api test:int levanta la aplicación real contra un PostgreSQL real y aplica las migraciones desde cero en cada ejecución — así se comprueba también que el esquema se construye solo. Dentro hay una prueba que lanza ocho creaciones de orden simultáneas y afirma que los números son distintos, otra que lanza cinco reenvíos del mismo uuid y afirma count(*) = 1, y otra que lanza tres aperturas de turno simultáneas y afirma que queda exactamente uno abierto.
Encima corren dos suites de Playwright en un navegador de verdad —ocho archivos en apps/web/e2e/—, y dos de ellas van justo a esto: offline-sync.spec.ts y service-worker.spec.ts.
Lo demás se lee: los guardas globales están en el módulo raíz, los 30 permisos en un archivo de semillas, y el índice parcial en su migración.
El dinero sigue exigiendo red
La cola sin conexión cubre el servicio —tomar una orden, avanzarla, verla en cocina— y deja fuera el cobro y la apertura de turno. Eso es deliberado y no un pendiente: un cobro encolado se reenvía sin que nadie mire el resultado, y en un turno de caja eso es un arqueo que no cuadra.
Lo que costaría cerrarlo no es la cola, que ya está. Es decidir qué hace el sistema cuando el cobro encolado falla al reenviarse y el cliente ya se fue: quién asume la diferencia y quién se entera. No tengo esa respuesta, y hasta tenerla el cobro se queda pidiendo red.
Redis está declarado y no se usa
Es una dependencia en el package.json, un servicio en el docker-compose.yml y un archivo de configuración que el módulo raíz carga, y no hay una sola línea que se conecte a él. El limitador de tasa usa el almacén en memoria, que es lo correcto mientras haya un solo proceso de API dentro del local. Está reservado para el adaptador de Socket.io y para el almacén del limitador el día que haya más de uno.
Lo digo porque un compose con Redis dentro insinúa una arquitectura que todavía no existe, y prefiero decirlo yo antes de que lo note alguien leyendo el repositorio.
Es de un solo establecimiento
No hay tenant_id en ninguna tabla, y la configuración del negocio es una tabla de una sola fila. Un despliegue es un local, y eso encaja con la topología: si el servidor está dentro del restaurante, no hay dos restaurantes en ese servidor. La instancia de loklflow.juank.tech no lo contradice, lleva los datos de un solo negocio: es una excepción de demostración, no la topología que este sistema defiende.
Añadir multi-tenencia después toca las 30 tablas y toca cada consulta. Es una decisión que no he tomado, no una que haya tomado a favor.
No hay trabajos en segundo plano
El arqueo del turno y los reportes se calculan cuando alguien los pide. Con un local y un turno por cajero eso es correcto; con veinte locales dejaría de serlo. No hay nada corriendo fuera del ciclo de una petición: ni cola de trabajos, ni cron, ni proceso aparte.