corebank
Un banco digital completo: cuentas, transferencias entre clientes, historial de movimientos y un asistente de IA al que le preguntas por tus saldos en lenguaje normal.
Arquitectura
Una API en Go entre dos almacenes: TigerBeetle tiene el dinero y PostgreSQL todo lo demás. No hay transacción distribuida — el uuid de la fila es el identificador del movimiento en el ledger.
- TigerBeetle es la fuente de verdad de saldos y movimientos: cuentas con débitos y créditos, y montos en centavos enteros. No guarda texto ni admite consultas ad-hoc.
- PostgreSQL guarda identidad, credenciales, números de cuenta, descripciones y el historial de auditoría. No puede garantizar invariantes contables.
- El navegador habla con la API por REST y por eventos del servidor; el asistente corre sobre un servidor MCP en el mismo proceso, y la clave de Anthropic es opcional.
- Una transferencia escribe en los dos: primero la fila en pendiente, luego el movimiento. Si el proceso muere en medio, al arrancar un barrido consulta ese identificador en el ledger y cierra la fila.
Backend Go 1.26 · chi · pgxLedger TigerBeetle 0.17.9Datos PostgreSQL 17 · gooseFrontend React 19 · Vite 6 · TanStack Query · Tailwind 4Asistente MCP · SDK de Anthropic para GoInfraestructura Docker Compose · nginx · GitHub Actions
Lo que me llevo
Una invariante que de verdad importa no se defiende con una comprobación: se defiende quitando la posibilidad. No hay columna de saldo, así que no puede desincronizarse; el modelo no puede confirmar, así que una inyección de prompts no escala a una pérdida; el tope de gasto compara e incrementa en una sola sentencia, así que no hay carrera que ganar. En los tres casos el costo fue perder una comodidad.
El caso completo — las decisiones, la evidencia y lo que falta
Un banco tiene una sola obligación que no puede fallar: el dinero que sale de una cuenta tiene que aparecer en otra, y ningún saldo puede quedar en negativo. Casi todos los sistemas que he leído cumplen eso con un if saldo < monto y una columna balance, y las dos cosas son promesas que alguien puede olvidar: la validación no cubre la ruta que se añade el mes siguiente, y la columna se desincroniza del historial que debería explicarla.
Este sistema no tiene ninguna de las dos. El saldo no existe como columna en ningún punto del esquema, y un sobregiro lo rechaza la propia base de datos financiera, no el código de aplicación. Lo que sigue son las cinco decisiones que hicieron falta para poder afirmar eso, y lo que costó cada una.
El sobregiro es imposible por construcción, no por validación
Lo que costóUna cuenta de patrimonio obligatoria, y no se puede consultar saldos con SQL
- Situación
Hacía falta que ninguna operación pudiera dejar una cuenta en negativo. No «que sea difícil»: que no exista un camino de código capaz de hacerlo, incluido el que yo escriba el mes que viene sin acordarme de esta regla.
- La decisión
La cuenta se abre en el ledger con la bandera que le prohíbe que sus débitos superen sus créditos. La regla vive en la base de datos financiera, no en el servicio.
- Lo que descarté
Un
if saldo < montoen la capa de servicio, más una columnabalanceen Postgres. Es lo que hace casi todo el mundo y pierde por una razón concreta: la validación cubre las rutas que existen el día que se escribe. La ruta nueva, el script de migración de datos, el endpoint interno de ajuste — cada uno es una oportunidad de omitirla. Y la columnabalanceintroduce una segunda fuente de verdad que puede discrepar del historial que supuestamente la explica.- La consecuencia
Ningún camino de aplicación puede omitir la comprobación porque no hay comprobación que omitir. El costo es real y son dos cosas: obliga a una cuenta de patrimonio como contraparte —los depósitos debitan
world, los retiros lo acreditan— y renuncia a consultar saldos con SQL ad-hoc, porque el saldo no está en Postgres. Cuando quiero un saldo, se lo pregunto al ledger.
It deliberately has NO balance column anywhere — balances are derived from TigerBeetle, which is the single source of truth for money. Two stores can never disagree about how much money exists if only one of them is allowed to answer the question.
El comentario está en el archivo que crea el esquema, y no es decorativo: la última frase es la razón entera de la decisión. Dos almacenes no pueden discrepar sobre cuánto dinero existe si sólo uno tiene permiso de responder la pregunta.
Los centavos son enteros, y el parseo trabaja sobre el texto del cliente
Lo que costóUn UnmarshalJSON a mano en el borde del sistema
- Situación
Los montos entran por JSON, que no distingue entre un número entero y uno de punto flotante. Había que convertirlos a la unidad mínima sin perder un centavo en el camino.
- Lo que rompía
float64(8.87) * 100no da 887. Da 886, porque 8,87 no tiene representación exacta en binario y el producto cae apenas por debajo. Un centavo por transacción, silencioso, y en un ledger de doble entrada un centavo que no cuadra es un asiento que no cierra.- La decisión
El tipo del dominio es un entero de 64 bits en centavos, y el
UnmarshalJSONse queda con el texto crudo que mandó el cliente para parsear sobre los dígitos, nunca sobre un flotante intermedio.- Lo que descarté
Decodificar a
float64y redondear al final, que es lo que hace el camino por defecto de cualquier librería JSON. Y también un tipo decimal de terceros: resuelve la aritmética pero no el borde que importa, porque el flotante ya se perdió en el decodificador antes de que el decimal exista.- La consecuencia
Hay un
UnmarshalJSONa mano que la mayoría de la gente consideraría innecesario, y una prueba que fija exactamente la diferencia entre 886 y 887 para que nadie lo «simplifique» más adelante. El costo es esa complejidad extra en el borde del sistema, concentrada en un archivo, a cambio de que el resto del código no tenga que pensar en el tema nunca.
Dos bases de datos, una sola verdad, y ninguna transacción distribuida
Lo que costóExiste un proceso de reconciliación que hay que entender
- Situación
El ledger guarda el movimiento del dinero; Postgres guarda todo lo demás — quién es el usuario, cómo se llama la cuenta, qué decía la descripción del movimiento. Una operación escribe en los dos, y no existe una transacción que abarque ambos.
- Lo que rompía
El problema clásico: si el proceso muere entre las dos escrituras, ¿qué quedó? Un movimiento en el ledger sin fila que lo explique, o una fila que promete un movimiento que nunca ocurrió.
- La decisión
El UUID de la fila en Postgres es el identificador de la transferencia en el ledger. Un solo valor, generado una vez, usado como clave en los dos lados.
- Lo que descarté
Un commit en dos fases entre los dos motores, que exige que los dos lo soporten y añade un coordinador que también puede caerse. Y un outbox con un worker, que es la respuesta correcta a escala; esperaría que añadiera latencia, y es una pieza más que mantener para un problema que aquí se resuelve con un identificador determinista.
- La consecuencia
Los reintentos son seguros por construcción: reintentar es escribir el mismo identificador, y el ledger rechaza el duplicado. Y hay un proceso de reconciliación que recorre las filas cuyo desenlace nunca se registró, lee el ledger y hace que la fila coincida. Nunca mueve dinero — sólo anota lo que el ledger ya hizo. El costo es que ese proceso existe y hay que entenderlo: un bug ahí puede reportar mal un movimiento, pero no puede perderlo ni duplicarlo.
El transfer pendiente en dos fases es la frontera de la IA
Lo que costóLa conversación tiene un paso más: el modelo nunca completa solo
- Situación
El sistema tiene un asistente que opera cuentas en lenguaje natural: «retira 250 dólares», «pásale 80 a mi cuenta de ahorros». Un modelo de lenguaje decidiendo movimientos de dinero es exactamente el tipo de cosa que no puede salir bien por accidente.
- La decisión
El modelo sólo puede preparar. Preparar crea una transferencia en estado pendiente, que retiene el monto sin liquidarlo. Confirmarla es un endpoint autenticado aparte, bajo la ruta de transacciones y no bajo la del chat, porque confirmar es una operación bancaria y no una conversación.
- Lo que descarté
Filtrar la salida del modelo —revisar lo que pide y bloquear lo peligroso— que es la respuesta habitual y pierde porque es una lista negra: protege de lo que se te ocurrió, y la inyección de prompts consiste precisamente en lo que no se te ocurrió. Y también una tabla propia de pendientes con un cron que limpie los vencidos, que funciona pero añade un proceso que puede fallar en silencio.
- La consecuencia
El hold lo expira el propio ledger cuando pasa su tiempo de vida, así que no hay proceso de limpieza: no existe el trabajo en segundo plano que podría caerse. La inyección de prompts deja de importar, porque lo peor que consigue un atacante es preparar una operación que el titular tiene que confirmar con su propia sesión. El costo es que la conversación tiene un paso más: el asistente nunca completa nada solo, y eso se siente en la interfaz.
El techo de gasto de la IA se construyó como el ledger
Lo que costó«¿Está disponible el asistente?» dejó de tener respuesta de sí o no
- Situación
Cada mensaje al asistente cuesta dinero real. Una demo pública con un formulario de registro abierto es una invitación a que alguien gaste mi presupuesto por mí.
- La decisión
Un solo
UPDATEque compara e incrementa en la misma sentencia, con el tope en la cláusulaWHERE. Si la sentencia afecta cero filas, la llamada no se hace. Los montos son enteros de micro-dólares, por la misma razón que los centavos son enteros. Hay tres topes —de por vida, diario y por usuario y día— y gana el más estrecho.- Lo que descarté
Leer el contador, comparar en Go y escribir el nuevo valor: la carrera clásica, y con varias peticiones concurrentes el tope se pasa. Y un límite por IP, que mide la cosa equivocada — no me importa cuántas peticiones haga alguien, me importa cuánto cuestan.
- La consecuencia
El presupuesto aguanta concurrencia porque el chequeo y el incremento son la misma operación, y hay una prueba con
-raceque lanza goroutines contra un tope pequeño para demostrarlo. Como el gasto se reserva con una estimación alta y se liquida con el costo real, la interfaz tiene cuatro estados en vez de un booleano, y dice cuál motor respondió. También existe un proveedor basado en reglas, así que la aplicación funciona con la clave de API vacía. El costo es que «¿está disponible el asistente?» dejó de tener una respuesta de sí o no.
Cómo se comprueba
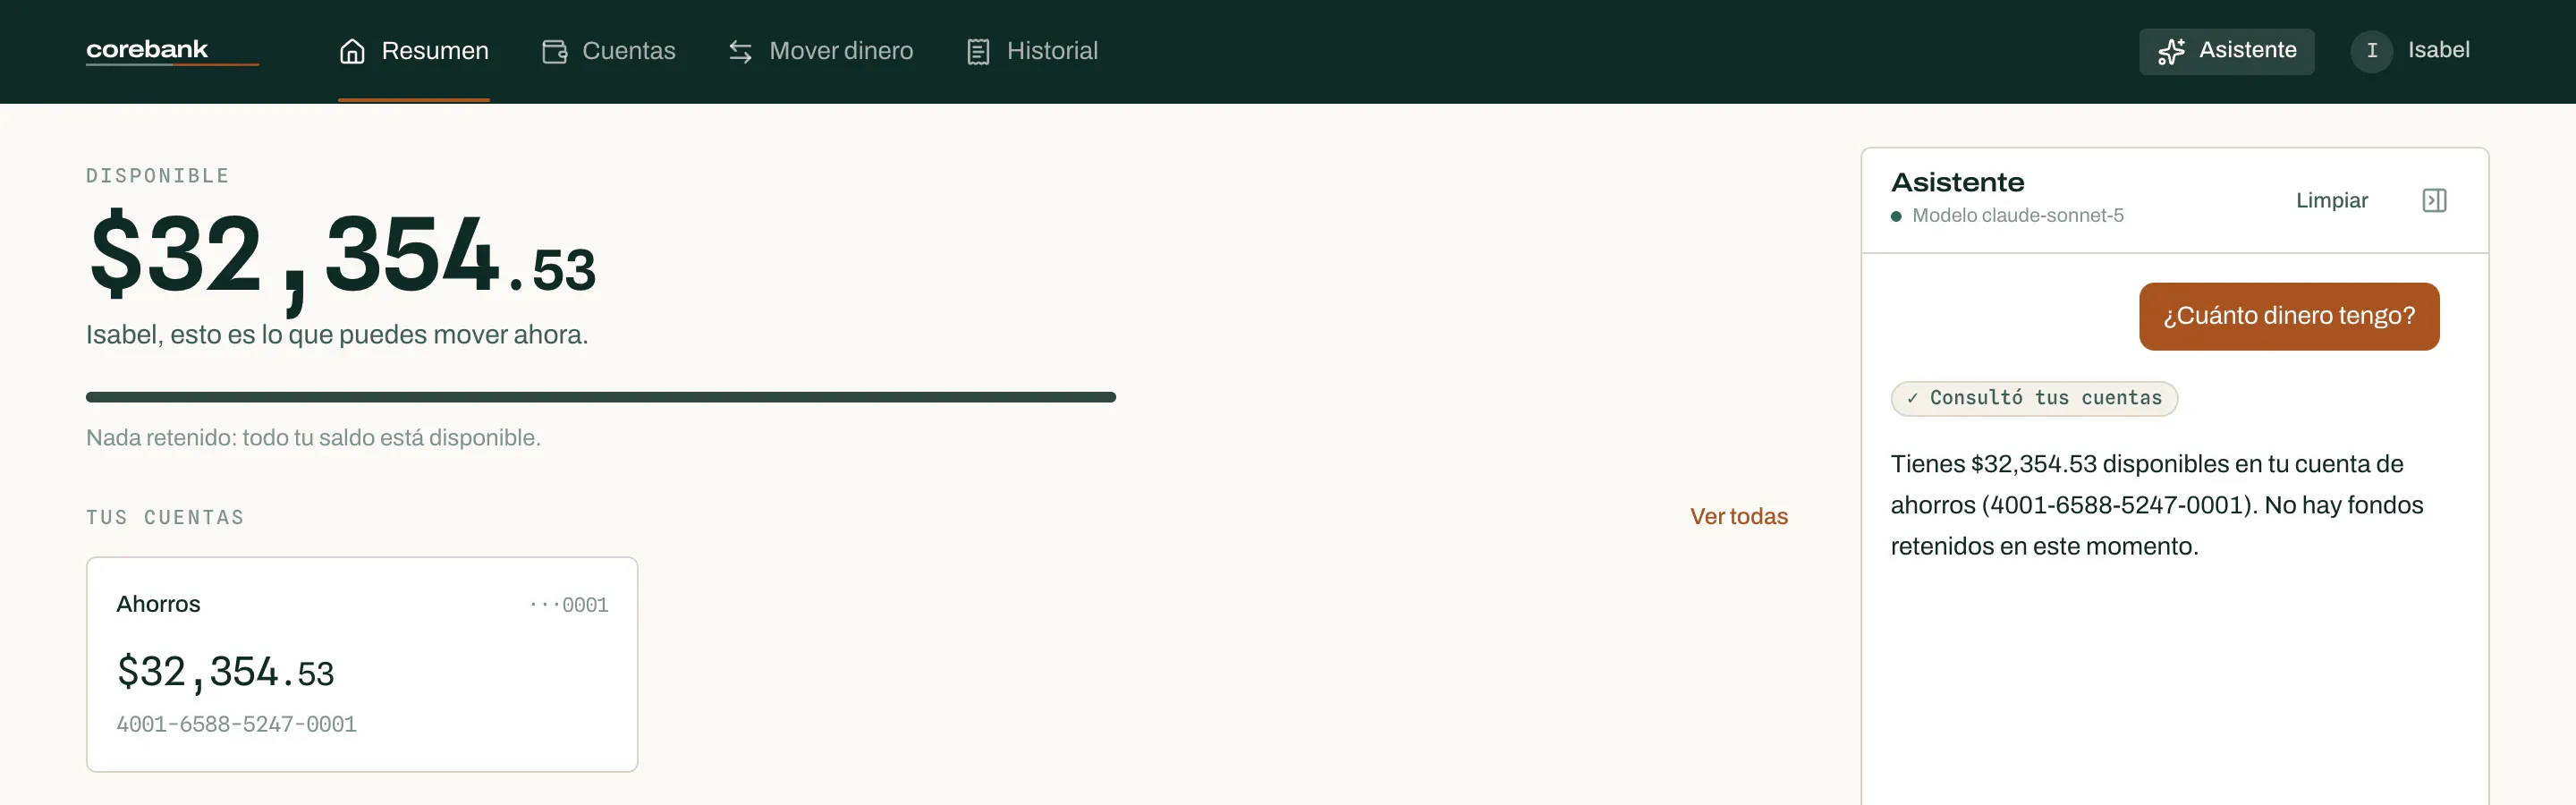
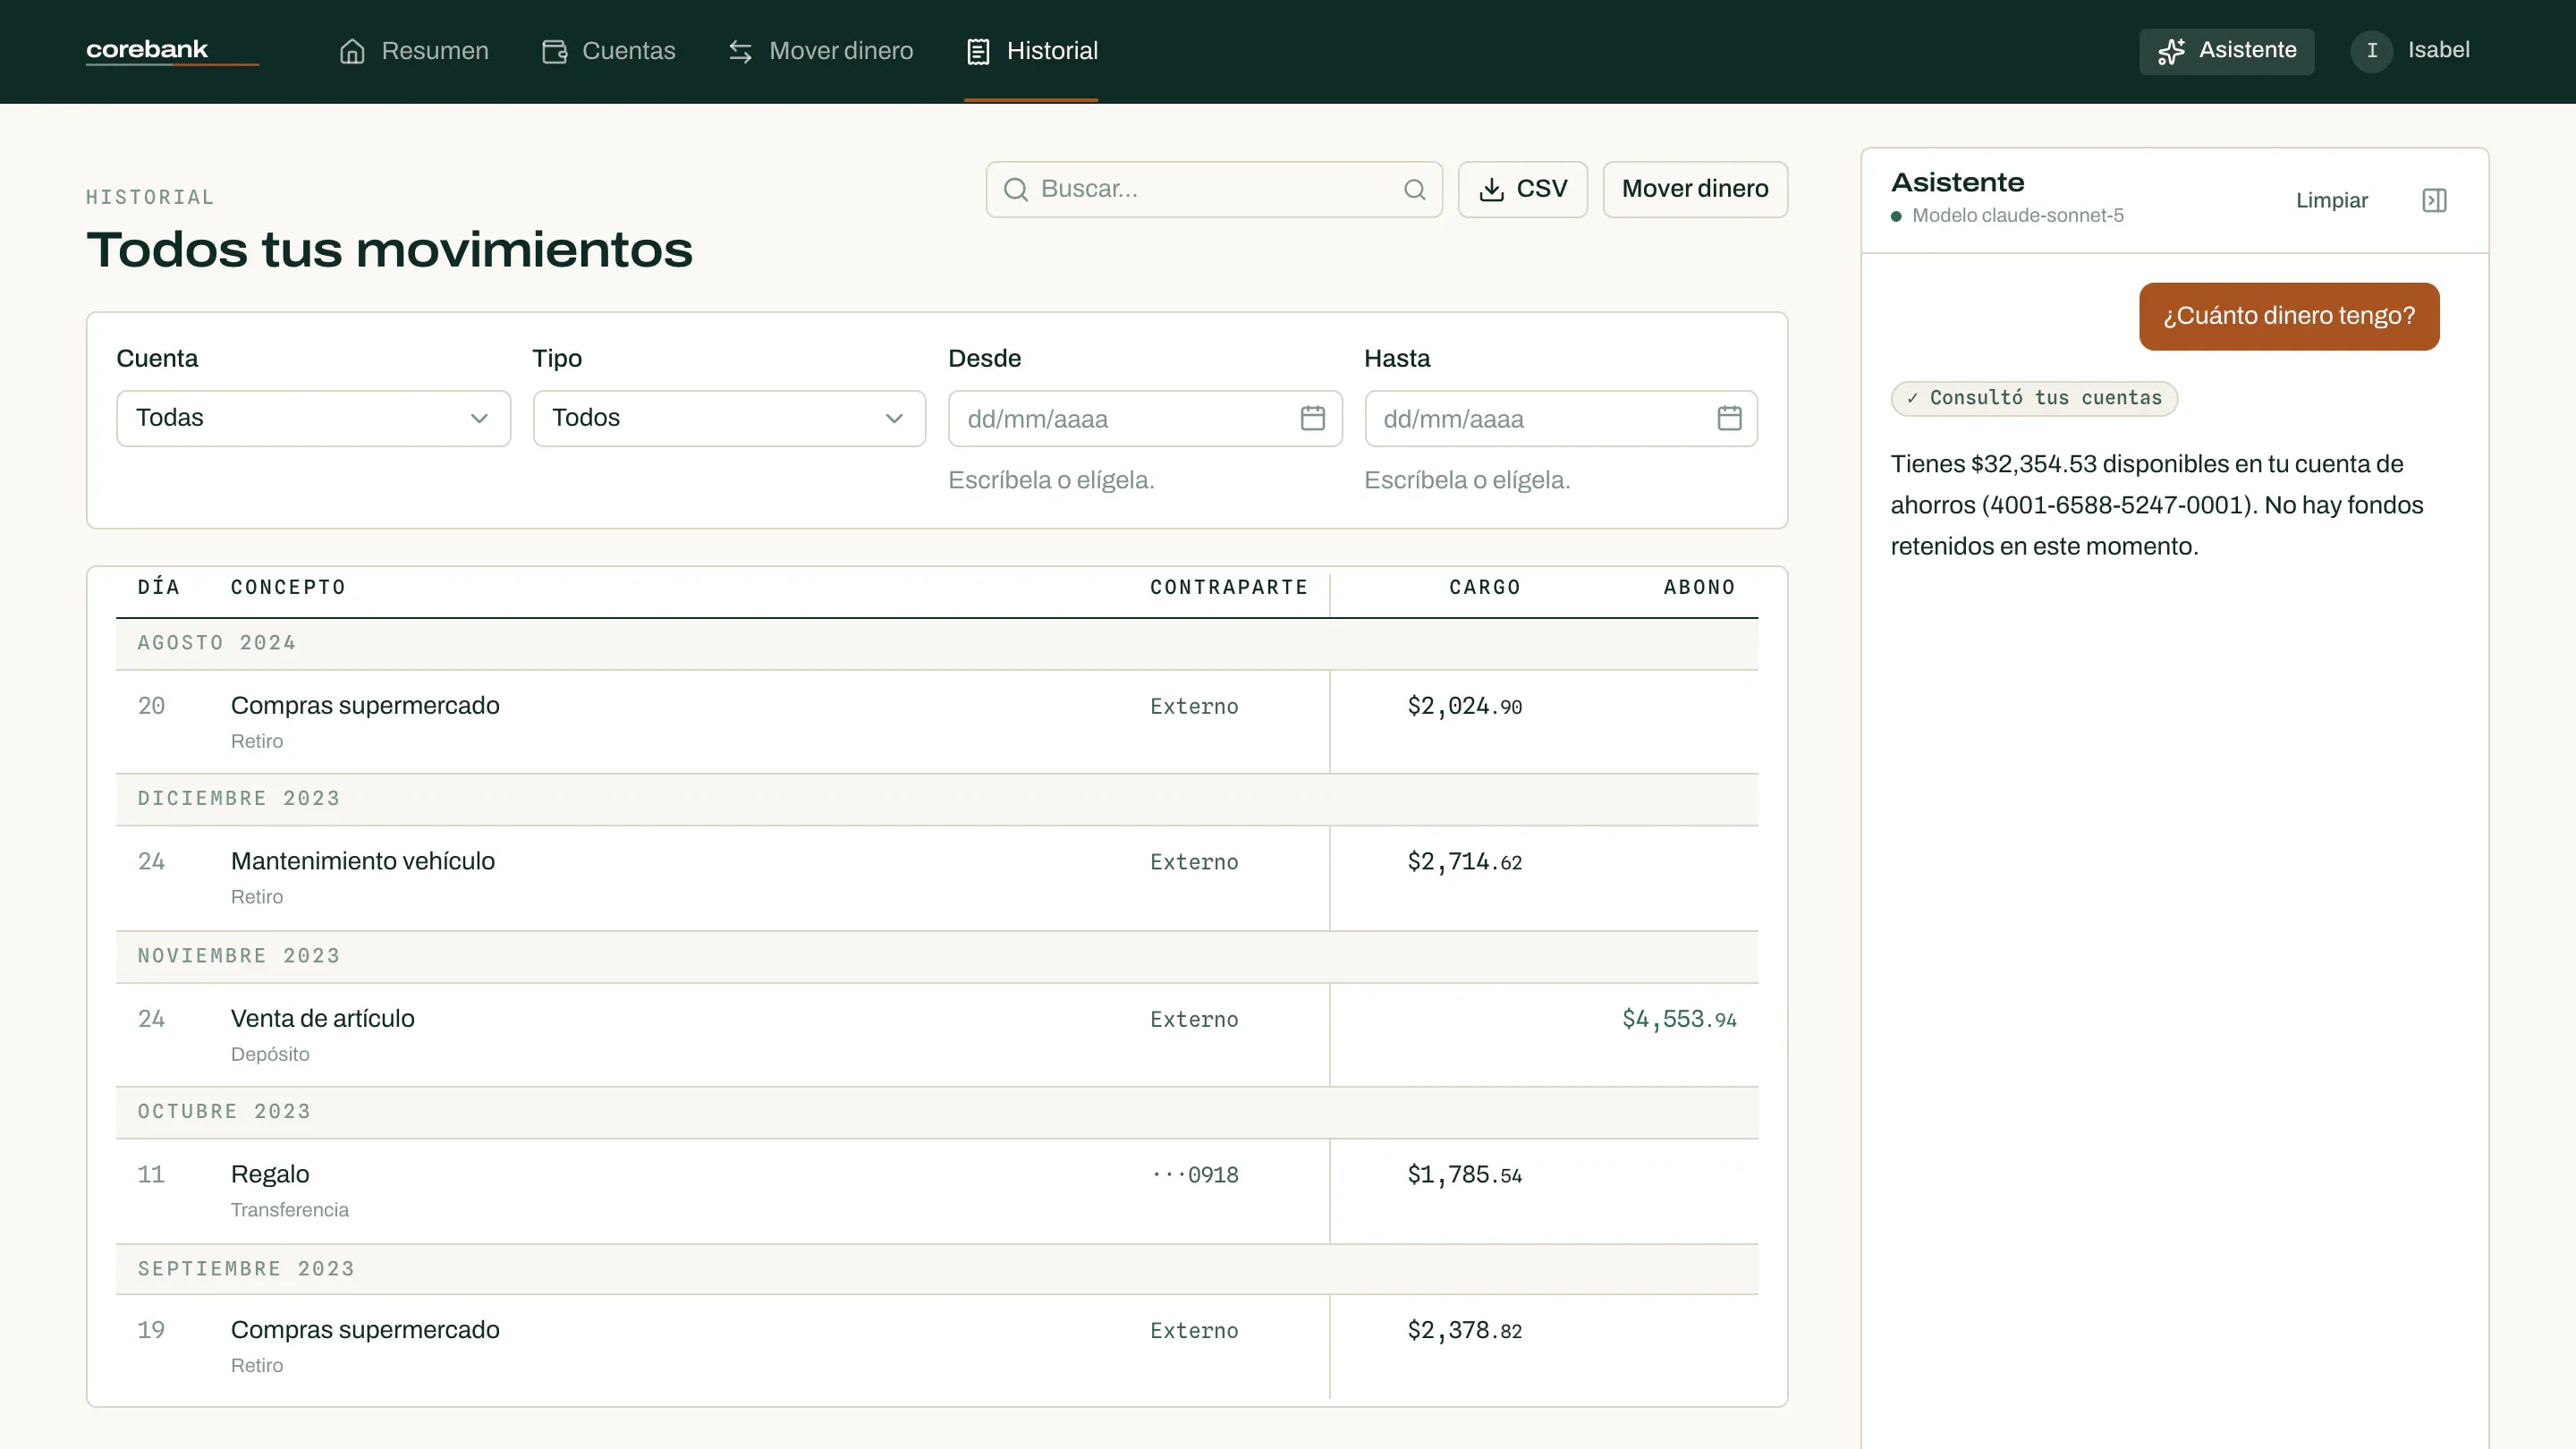
Casi todo lo de arriba se puede verificar sin ejecutar nada. Que no hay columna de saldo se ve en la primera migración, que lo dice en un comentario y además no la contiene. Que el sobregiro lo rechaza el ledger se ve en la bandera con la que se abre la cuenta. Las seis herramientas del asistente están en un archivo, y ninguna acepta un identificador de usuario: la identidad se inyecta desde el token, fuera del alcance del modelo.
Lo que sí conviene ejecutar es la suite: go test -race ./... corre en un checkout limpio, porque la única prueba que necesita un TigerBeetle de verdad se salta a sí misma cuando no lo encuentra. Y la demo está en vivo, con dos cuentas de prueba documentadas en el repositorio.
No hay TigerBeetle en CI
La prueba que ejercita el cliente real del ledger llama a t.Skip() si no hay una instancia disponible, y en CI no la hay. Eso mantiene la suite verde en cualquier máquina, y a cambio la integración con el ledger no está cubierta automáticamente: la compruebo levantando el compose a mano.
Levantarlo en CI cuesta un servicio más en el workflow, memoria adicional reservada y un paso de formateo antes de arrancar. Lo haría el día que toque el cliente del ledger otra vez; hoy la relación entre lo que cuesta y lo que cubre no me convence.
Las imágenes se recompilan en el VPS
El despliegue construye las imágenes en el servidor en vez de tirarlas de un registro. Funciona, y esperaría que fuera más lento de lo necesario —no lo he cronometrado—, y es el punto abierto que el propio README del proyecto declara. Publicarlas desde CI es la mejora obvia y no está hecha.
El dataset de siembra era incoherente, y elegí una lectura
Los datos con los que se siembra la demo llegaron de un tercero y no cuadran consigo mismos: según cómo se interpreten los movimientos, un mismo grupo de cuentas termina con saldos distintos, y varias quedan en negativo en cualquiera de las lecturas. Lo analicé antes de escribir el importador, precisamente para no descubrirlo después.
Elegí la lectura que hace que los saldos visibles sean exactos, y las cuentas que quedan negativas quedan negativas: son movimientos históricos que se registran como auditoría, no operaciones que pasen por la regla de sobregiro. No voy a afirmar que sea la única lectura defendible. Es la que elegí y la razón por la que la elegí.
Las 87 pruebas no tocan el frontend
Las 87 funciones de prueba son de Go, todas. En web no hay un solo archivo .test.ts ni .test.tsx, no hay vitest ni testing-library en el package.json, y no existe el script test: el trabajo web del CI instala, revisa formato, hace typecheck y compila, y ahí termina. Las 9.676 líneas de TypeScript las comprueba el compilador y nadie más. Tampoco hay pruebas end-to-end: el recorrido de registrarse, preparar una transferencia con el asistente y confirmarla lo verifico a mano contra la demo.
Pasa porque las invariantes que me importaban —el sobregiro, los centavos, el tope de gasto, la reconciliación— viven en Go y en el ledger, y ahí puse las pruebas. Cubrir la interfaz cuesta montar vitest con testing-library y aislar TanStack Query en cada prueba, y sostenerlo mientras las pantallas todavía cambian; el recorrido completo cuesta además un Playwright con el compose levantado en CI.
Lo haría el día que un cambio de frontend rompa algo que el typecheck no vea, o el día que la interfaz deje de ser sólo mía. Hoy la lógica que puede perder dinero no está en el navegador, y esa es la única razón por la que acepté la brecha; si eso cambia, la razón se cae.